Hôm nay, mình tìm hiểu về Embedding Models cho tiếng Việt thì có tình cờ xem được paper này khá hay, về việc xây dựng một benchmark đủ hiệu quả để đánh giá độ hiệu quả của một mô hình Embedding đối với tiếng Việt. Trong bài viết này mình sẽ tóm tắt những điểm quan trọng từ paper, những điểm hay, đáng học hỏi và những điểm cải thiện mình đề xuất trong quá trình xây dựng thêm bộ dataset native cho ngôn ngữ Việt Nam.
Về paper, được viết bởi nhóm tác giả:
Loc Pham♠, Tung Luu♠, Thu Vo♠, Minh N. T. Nguyen♣, Viet Hoang♠,
♠ GreenNode AI, Singapore
♣School of Electrical Engineering, International University, VNU-HCMC, Vietnam
{locpb, tunglq, thu, viethq5}@greennode.ai, {nntminh}@hcmiu.edu.vn
Các bạn có thể đọc paper tại đây
I. Vì sao VN-MTEB ra đời ?
Trước khi paper này ra đời, M-MTEB đã có benchmark cho nhiều ngôn ngữ, tuy nhiên đối với tiếng Việt chỉ có 18 datasets, trong khi tiếng Anh có tới hơn 300. Nhóm tác giả cho rằng như vậy chưa đủ để đánh giá một embedding model tiếng Việt trên nhiều loại bài toán. Vì vậy họ tạo một pipeline tự động để tạo ra VN-MTEB gồm 41 datasets, trải ra trên 6 task
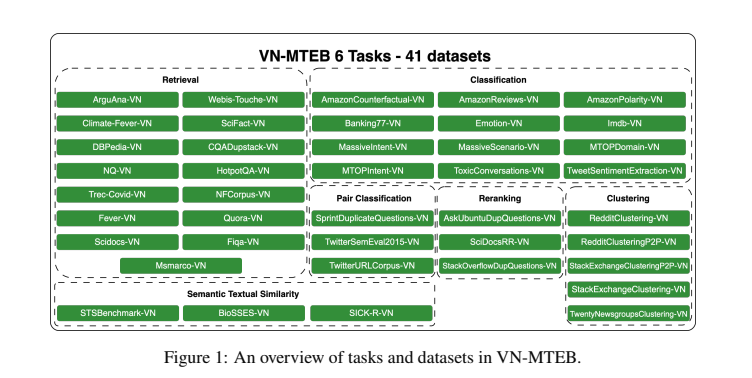
Từ đây mình cũng rút ra được một ý rất quan trọng: Một embedding mmodel tốt không chỉ có nghĩa là cosine similarity giữa hai câu cao. Nó còn phải làm tốt các nội dung: Retrieval, Classification, STS, Clustering, Ranking và Pair Classification.
II. Pipeline tạo dataset tiếng Việt
Nhóm tác giả không tự ngồi viết hàng triệu mẫu tiếng Việt. Họ tận dụng dataset tiếng Anh đã tồn tại trong MTEB rồi xây pipeline:
English MTEB -> Stage 1: Language Detection -> Stage 2: LLM Translation -> Stage 3: Quality Filtering
Đây chính là tư tưởng synthetic data và quality filtering. Điểm quan trọng của pipeline này không chỉ là dùng LLM dịch dataset mà còn là Generate, Validate và Filter.
LLM Translation
Stage 2 sử dụng LLM để dịch, nhưng nhóm tác giả không chỉ yêu cầu LLM dịch mà còn yêu cầu bản dịch phải đảm bảo các yếu tố: Ngữ nghĩa, tên thực thể, code snippets, số học, liên kết, các kí tự đặc biệt và ngôn ngữ tự nhiên của Việt Nam.
Sau khi thử nghiệm nhiều loại model dịch như: NLLB-200, SeamlessM4T, VinAI Translate,... nhóm cuối cùng chọn Aya-23-35B. Trong thử nghiệm so với reference do con người tạo, Aya-23-35B đạt BLEU cao nhất trong các task mà nhóm tác giả báo cáo
Theo mình suy nghĩ: Các model như OpenAI's GPT-4, Google's Gemini,... hoàn toàn có thể làm tốt nhiệm vụ này tuy nhiên việc đánh đổi chi phí để lấy hiệu năng lúc này là quá lớn. Sử dụng một mô hình 35B là hoàn toàn đủ cho các tác vụ này.
III. Ba tầng Validation mà nhóm tác giả sử dụng
Trong Stage 3: Quality Filtering, nhóm tác giả sử dụng ba tầng Validation. Đây là phần quan trọng nhất để làm dataset đáng tin hơn, chống lại các vấn đề như: Bias, ảo giác, ...
Bước 1: Language Detection:
Đây là bước để kiểm tra output thực sự là tiếng Việt. Khi sử dụng FastText, đôi lúc nhận diện sai những đoạn có code, tên riêng, text có nhiều ngôn ngữ, kí hiệu,... Vì vậy nhóm đã thử nghiệm và nhận thấy thấy Qwen 2.5 Instruct xử lý tốt hơn trong trường hợp này, nên sử dụng LLM nhẹ để xác định chính xác ngôn ngữ
Bước 2: Semantic Similarity Filter:
Ý tưởng là so sánh Semantic Similarity giữa 2 ngôn ngữ, nhóm tác giả lấy Original English Embedding để so sánh với Translated Vietnamese Embedding. Ở bước này, hệ thống sử dụng Alibaba-NLP/gte-Qwen2-7B-Instruct. Model này đa ngôn ngữ nên khi xét:
embedding1 = model.encode("Artificial Intelligence...")
embedding2 = model.encode("Trí tuệ nhân tạo")
Thì 2 embedding hoàn toàn vẫn có thể so sánh được. Sau đó tiến hành khảo sát distribution trên các loại pair:
English ↔ Vietnamese translation
English ↔ English synonym
English ↔ Vietnamese contradiction
English ↔ unrelated Vietnamese
Từ đó rút ra được kết luận để chọn ngưỡng phù hợp: semantic similarity >= 0.8; mẫu dưới 0.8 sẽ bị loại. Đây cũng là một ý tưởng rất hay cho embedding model:
Embedding model cũng có thể được dùng để kiểm tra chất lượng dataset dùng để train embedding model khác.
Bước 3: LLM-as-a-Judge
Cosine similarity không bắt hết lỗi.
Ví dụ một bản dịch có thể gần nghĩa nhưng:
- sai tên người;
- mất con số;
- sai URL;
- câu tiếng Việt không tự nhiên;
- mất đoạn code;
- grammar tệ.
Vì vậy họ dùng Llama-SEA-LION-v3-70B-IT làm judge và đánh giá nhiều tiêu chí: Ngữ pháp, NER, Number/links, Fluency,... Mỗi tiêu chí được chấm điểm, sau đó tổng hợp bằng weighted score và chỉ giữ sample vượt threshold. Họ còn dùng CoT prompting để model phân tích trước khi chấm.
III. Những limitation được đề cập
Limitation 1: Dataset không phải Vietnamese-native: Phần lớn dữ liệu là English dataset -> Translation -> Vietnamese chứ không phải dữ liệu tạo tự nhiên bởi người Việt. Do đó paper thừa nhận thiếu những yếu tố như: cultural context, formal, dialect
Ví dụ như văn bản tiếng Việt thật đôi khi sẽ có các kí tự viết tắt, địa danh,... Trong datasets tiếng Anh sẽ khó xuất hiện những yếu tố như thế này
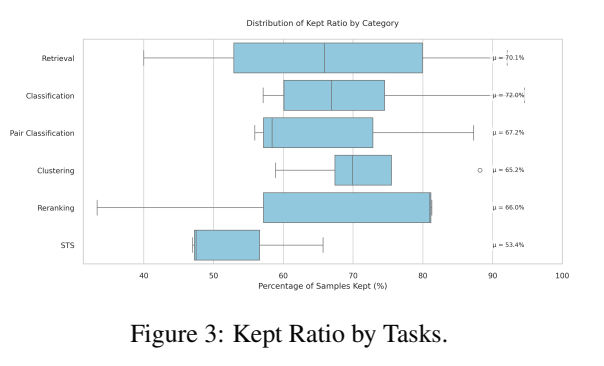
Limitation 2: Pipeline mất data nhưng không regeneration: Nếu sample fail thì sẽ drop và không yêu cầu LLM dịch lại. Theo mình đó là sự trade-off đối với bài toán kinh phí khi sử dụng LLM kèm với bộ 4 GPU H100. Và điều này làm một số dataset mất phần lớn data
IV. Những điều mình rút ra được từ kết quả Benchmark:
Sau khi mình xem kĩ Table 3 trong Paper, mình rút ra được một số bài học trong quá trình xây dựng bộ dữ liệu và huấn luyện một embedding model như sau
- Model chuyên tiếng Việt không mặc nhiên thắng:
Các model multilingual mạnh như: m-e5-large-instruct, e5-Mistral, gtr-Qwen2,... đều có thể vượt qua các model chuyên tiếng Việt trong Benchmark này. Điều đó có nghĩa là
Fine-tune cho tiếng Việt không tự động khiến model tốt hơn model multilingual.
- Instruct tuning có ảnh hưởng rất rõ:
So sánh cặp m-e5-large: 63.87 & m-e5-large-instruct: 67.99 cùng họ model nhưng kết quả tăng đáng kể. Instruct embedding tức là model được biết task mà embedding đang phục vụ qua instruction.
Ví dụ concept:
"Instruct: Retrieve documents relevant to this question - Query: Hà Nội thuộc miền nào?" khác với chỉ encode: "Hà Nội thuộc miền nào ?"
V. Kết luận
Sau khi đọc paper này, điều mình thấy đáng học nhất không nằm ở việc VN-MTEB có thêm bao nhiêu dataset, mà nằm ở cách nhóm tác giả xây dựng và kiểm soát chất lượng dữ liệu.
Thay vì chỉ dịch dataset tiếng Anh sang tiếng Việt rồi sử dụng trực tiếp, nhóm xây dựng một pipeline khá rõ ràng:
Generate -> Validate -> Filter -> Benchmark
Trong đó mỗi tầng validation lại giải quyết một loại lỗi khác nhau. Language Detection kiểm tra đúng ngôn ngữ, Embedding kiểm tra semantic và LLM-as-a-Judge kiểm tra những lỗi khó biểu diễn bằng cosine similarity như tên riêng, con số, URL hay độ tự nhiên của câu.
Đối với mình, đây cũng là phần quan trọng nhất nếu muốn tự xây dựng một dataset để fine-tune Embedding Model cho tiếng Việt. Model tốt đến đâu nhưng dữ liệu positive, negative hoặc query bị sai thì kết quả cuối cùng vẫn rất khó tốt được.
Tuy nhiên, VN-MTEB vẫn chủ yếu là dữ liệu được dịch từ tiếng Anh. Vì vậy nếu muốn đi thêm một bước nữa, mình nghĩ cần bổ sung một tập dữ liệu Vietnamese-native, được xây dựng trực tiếp từ dữ liệu tiếng Việt thực tế. Ví dụ như báo chí Việt Nam, diễn đàn, văn bản hành chính, câu hỏi tìm kiếm, hội thoại, dữ liệu thương mại điện tử,... Sau đó mới sử dụng synthetic data để mở rộng các cặp query-positive-negative thay vì dùng synthetic data làm nguồn chính.
Một điểm nữa mình rút ra được là khi xây dựng Embedding Model, không nên chỉ nhìn vào một task Retrieval hoặc một vài ví dụ cosine similarity. Một model thực sự tốt cần được kiểm tra trên nhiều dạng bài toán khác nhau, đồng thời phải so sánh với những multilingual model mạnh hiện tại.
VN-MTEB theo mình là một paper khá đáng đọc nếu đang tìm hiểu về Embedding, Dataset Construction hoặc Benchmarking cho tiếng Việt. Nó không đưa ra một kiến trúc embedding hoàn toàn mới, nhưng cung cấp khá nhiều ý tưởng thực tế về cách xây dựng dữ liệu, lọc dữ liệu và đánh giá model.
Và đây cũng là một trong những paper khiến mình nhận ra rằng trong nhiều bài toán Machine Learning:
Xây đúng dataset đôi khi quan trọng không kém việc chọn đúng model.
Thảo luận bài viết
Câu hỏi, ghi chú và góc nhìn của bạn về nội dung này.