Khi xây dựng một chatbot hoặc thử Pipeline RAG, đôi khi mình chỉ cần một API để gọi LLM. Nếu tự tải Model về máy, mình còn phải xử lý VRAM, môi trường chạy và cách phục vụ nhiều request. Hugging Face Inference Providers là một hướng để bắt đầu từ phần ứng dụng: chọn Model đang được hỗ trợ, gửi messages và nhận kết quả từ hạ tầng của provider.
Trong bài này, mình đi từ bước chuẩn bị token đến gọi API bằng Python, nhận câu trả lời streaming và chọn cách tích hợp phù hợp. Các đoạn code là ví dụ theo tài liệu chính thức, chưa phải kết quả benchmark hoặc một lần chạy API thực tế.
I. Inference Providers hoạt động như thế nào?
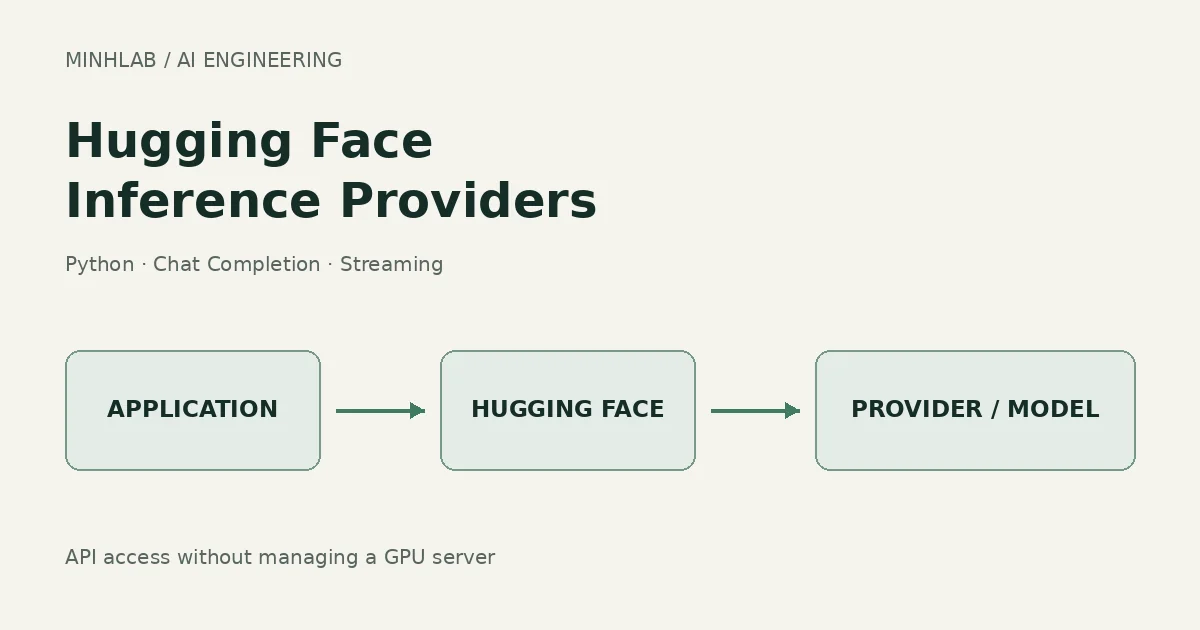
Có thể hình dung luồng gọi như sau:
Ứng dụng → Hugging Face → Inference Provider → Model → kết quả.
Model là mô hình bạn muốn sử dụng; provider là đơn vị vận hành hạ tầng để chạy mô hình đó. Ví dụ, cùng một Model có thể được phục vụ bởi nhiều provider. Khi dùng Hugging Face token cho routed requests, Hugging Face phụ trách lớp xác thực và định tuyến.
Inference Providers khác với việc tải weights từ Hub về máy. Nó cũng khác Inference Endpoints, nơi bạn triển khai Model lên hạ tầng chuyên dụng được quản lý. Với Providers, mình sử dụng những cặp Model–provider đang có sẵn. Một repo xuất hiện trên Hub không có nghĩa là repo đó đã có API inference.
Tham khảo: Run Inference on servers.
II. Chuẩn bị Model, token và môi trường
Trước hết, mở Models trên Hub, lọc theo Inference Providers rồi kiểm tra Model có hỗ trợ Chat Completion. Bạn có thể thử prompt trên widget hoặc Inference Playground và xem code snippet của cặp Model–provider đã chọn.
Tiếp theo, vào Access Tokens, tạo fine-grained token với quyền Make calls to Inference Providers. Lưu token ở biến môi trường HF_TOKEN trên máy chạy Backend; không đưa token vào JavaScript phía trình duyệt hoặc commit vào Git.
Ví dụ dưới đây dùng openai/gpt-oss-120b. Đây là ID của Model trên Hugging Face; token xác thực vẫn là Hugging Face token. Danh sách Model và provider có thể thay đổi, nên hãy kiểm tra trang Model trước khi chạy.
Trong môi trường Python của project, cài client nếu chưa có:
python -m pip install huggingface_hub

# Bash: read the token without echoing it or saving it in shell history.
read -r -s -p "HF token: " HF_TOKEN
printf "\n"
export HF_TOKEN
Sau khi đặt HF_TOKEN trong môi trường chạy, bạn có thể kiểm tra bằng một request ngắn. Các ví dụ chỉ gọi dịch vụ từ xa, nên máy chạy client không cần GPU hoặc PyTorch.
Tham khảo: Your First API Call.
III. Gọi LLM bằng Python
Tạo file chat_example.py. Mình giữ Model và messages thành biến riêng để dễ thay prompt khi thử nghiệm:
import os
from huggingface_hub import InferenceClient

model_id = "openai/gpt-oss-120b"
messages = [
    {"role": "system", "content": "You are a helpful assistant. Reply in Vietnamese."},
    {"role": "user", "content": "Giải thích RAG bằng một ví dụ ngắn."},
]

client = InferenceClient(
    provider="auto",
    api_key=os.environ["HF_TOKEN"],
    timeout=60,
)

response = client.chat.completions.create(
    model=model_id,
    messages=messages,
    max_tokens=300,
)

print(response.choices[0].message.content)
client gửi request HTTP; phần tính toán diễn ra ở provider. max_tokens giới hạn độ dài đầu ra, còn timeout đặt thời gian chờ của client. Đọc câu trả lời tại response.choices[0].message.content.
Sau khi lưu file, chạy bằng Python trong cùng môi trường đã có HF_TOKEN. Nếu gặp KeyError: HF_TOKEN, biến chưa được đặt trong tiến trình đó. Ví dụ chỉ giữ một lượt hỏi; muốn hội thoại nhiều lượt, bạn cần bổ sung các messages trước đó và quản lý độ dài Context.
IV. Nhận kết quả từng phần bằng streaming
Với giao diện chat, mình thường muốn hiển thị nội dung ngay khi có phần trả lời đầu tiên. Dùng lại client, model_id và messages ở ví dụ trên, thay lời gọi API bằng:
stream = client.chat.completions.create(
    model=model_id,
    messages=messages,
    max_tokens=300,
    stream=True,
)

for chunk in stream:
    if not chunk.choices:
        continue
    text = chunk.choices[0].delta.content
    if text:
        print(text, end="", flush=True)

print()
Mỗi chunk chứa một phần thay đổi ở delta.content. Một số chunk chỉ mang metadata hoặc không có nội dung văn bản, nên vòng lặp kiểm tra trước khi in. Streaming cải thiện thời gian chờ cảm nhận của người dùng; nó không tự làm tổng thời gian suy luận ngắn hơn.
Với Web, Backend có thể chuyển các phần này về giao diện qua SSE. Khi kết nối bị ngắt giữa chừng, hãy cho người dùng biết câu trả lời chưa hoàn tất. Tham khảo Chat Completion.
V. Nếu project đã dùng OpenAI SDK
Bạn có thể dùng endpoint tương thích Chat Completions. Cài package openai trong môi trường project nếu chưa có, rồi thay base_url và API key như dưới đây:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
    timeout=60,
)

response = client.chat.completions.create(
    model="openai/gpt-oss-120b:cheapest",
    messages=[{"role": "user", "content": "RAG là gì? Trả lời bằng tiếng Việt."}],
    max_tokens=300,
)

print(response.choices[0].message.content)
Endpoint trên dùng cho Chat Completions. Với tác vụ như tạo ảnh hoặc xử lý âm thanh, hãy dùng phương thức phù hợp của Hugging Face client.
VI. Chọn provider và kiểm soát chi phí
provider="auto" để hệ thống chọn provider. Khi cần cố định hạ tầng, hãy chỉ định tên provider được trang Model hỗ trợ. Với endpoint tương thích OpenAI, bạn có thể thêm suffix vào Model ID:
- :fastest: ưu tiên throughput, đo bằng tokens/giây.
- :cheapest: ưu tiên giá output token thấp nhất.
- :preferred: theo thứ tự trong Inference Provider settings.
Throughput cao không đảm bảo thời gian tới token đầu tiên thấp nhất. Mình sẽ so sánh trên cùng prompt, độ dài Context và giới hạn output trước khi quyết định. Chi tiết: Provider Selection.
Routed requests dùng Hugging Face token và tính phí qua tài khoản Hugging Face. Nếu cấu hình custom provider key, provider tính phí trực tiếp và credit của Hugging Face không áp dụng.
Credit miễn phí có giới hạn; Model open-weight không đồng nghĩa API miễn phí không giới hạn. Trước khi chạy nhiều request, kiểm tra Billing và usage theo Model/provider. Mức credit và giá có thể thay đổi, nên xem Pricing and Billing tại thời điểm sử dụng.
VII. Lỗi thường gặp và cách đưa vào ứng dụng
Khi request lỗi, mình kiểm tra theo thứ tự: token có đúng quyền không, cặp Model–provider có hỗ trợ tác vụ không, tài khoản còn credit không và thông báo trả về nói gì.
- 401/403: kiểm tra token, quyền inference và quyền truy cập Model nếu có yêu cầu.
- 400 hoặc báo không hỗ trợ Model/task: đối chiếu code snippet của trang Model và các tham số gửi lên.
- 429: giảm số request đồng thời; retry có backoff và giới hạn số lần.
- Timeout hoặc lỗi 5xx: kiểm tra trạng thái dịch vụ, rồi thử lại có giới hạn. Không retry mọi lỗi một cách vô hạn.
Đây là cách khoanh vùng chung; hãy đọc body lỗi vì mã HTTP cụ thể có thể khác giữa provider. Khi đưa vào Backend, mình sẽ tái sử dụng client, giới hạn đầu vào, đặt timeout và ghi log trạng thái request. Nếu dùng route async, chọn AsyncInferenceClient hoặc chuyển lời gọi đồng bộ sang thread pool để tránh chặn event loop.
Với RAG, API này nằm ở bước sinh câu trả lời sau Retrieval. Bạn vẫn phải chuẩn bị chunks, tìm Context và đánh giá câu trả lời có bám tài liệu hay không. Có thể nối phần này với Pipeline trong bài MyNotebook.
Dữ liệu được gửi tới dịch vụ inference. Trước khi xử lý tài liệu riêng tư, kiểm tra chính sách của provider đã chọn; không suy ra rằng mọi provider có cùng chính sách chỉ vì dùng chung một client. Tham khảo Security & Compliance.
Kết luận
Hugging Face Inference Providers giúp bắt đầu một ứng dụng gọi Model mà chưa phải tự vận hành GPU server. Với mình, cách thử hợp lý là chọn một cặp Model–provider, gửi prompt ngắn, kiểm tra nội dung và usage, rồi mới thêm streaming và hội thoại nhiều lượt.
API giải quyết bước truy cập Model. Chất lượng của ứng dụng vẫn cần kiểm tra bằng dữ liệu và câu hỏi của chính project. Khi cần triển khai Model riêng hoặc kiểm soát hạ tầng sâu hơn, hãy cân nhắc Inference Endpoints hoặc tự phục vụ Model.
Đối chiếu tài liệu chính thức ngày 06/10/2026. Các ví dụ trong bài chưa được chạy bằng token thật và chưa đo tốc độ hoặc chi phí thực tế.
Thảo luận bài viết
Câu hỏi, ghi chú và góc nhìn của bạn về nội dung này.