Sau khi Fine-tune VietRAG-Embed, mình muốn đưa Embedding Model vào một ứng dụng có thể sử dụng từ đầu đến cuối: tải tài liệu, đặt câu hỏi và đọc câu trả lời ngay trên Web.
Từ đó mình xây dựng MyNotebook, một project hỏi đáp tài liệu bằng Retrieval-Augmented Generation (RAG). Trọng tâm của project là kết nối Retrieval tiếng Việt, Backend và giao diện thành một luồng xử lý hoàn chỉnh, đồng thời mở rộng sang Agent có khả năng sử dụng công cụ.
I. MyNotebook giải quyết bài toán gì?
Khi đọc một tài liệu dài, việc tìm đúng đoạn liên quan thường mất nhiều thời gian hơn việc đặt câu hỏi. MyNotebook cho phép người dùng tải tài liệu vào từng cuộc hội thoại, sau đó hỏi bằng ngôn ngữ tự nhiên.
Hệ thống tìm các đoạn phù hợp rồi đưa chúng vào Context để LLM tạo câu trả lời. Cách này giúp câu trả lời có cơ sở từ tài liệu đã tải lên; chất lượng cuối cùng vẫn phụ thuộc vào bước trích xuất, Retrieval và Model sinh nội dung.
Bản demo trong bài tập trung vào PDF có lớp văn bản. Giao diện hỗ trợ lịch sử hội thoại, hiển thị Markdown và trả kết quả dần qua streaming.
II. Từ PDF đến câu trả lời
Pipeline chính gồm năm bước:
- Trích xuất và làm sạch: PyMuPDF đọc văn bản trong PDF, sau đó chuẩn hóa nội dung trước khi chia nhỏ.
- Chunking: chia tài liệu theo cấu trúc văn bản với kích thước 400 tokens và overlap 60 tokens, đo bằng tokenizer của multilingual-e5-base.
- Embedding: VietRAG-Embed mã hóa Passage thành vector 768 chiều đã Normalize. Prefix
passage:vàquery:được giữ nhất quán khi lập chỉ mục và tìm kiếm. - Hybrid Search: Qdrant kết hợp Dense Retrieval và BM25, rồi hợp nhất hai danh sách bằng Reciprocal Rank Fusion (RRF).
- Sinh câu trả lời: LLM nhận Context cùng bản tóm tắt hội thoại. FastAPI truyền kết quả về giao diện bằng Server-Sent Events (SSE), sau đó lưu lịch sử và cập nhật summary trong Supabase.
Mình chọn Hybrid Search vì hai hướng tìm kiếm bổ sung cho nhau: Dense Retrieval hỗ trợ tìm theo ý nghĩa, còn BM25 hữu ích với từ khóa và thuật ngữ cụ thể. Đây là lựa chọn kiến trúc của project; để kết luận mức cải thiện, vẫn cần so sánh trên bộ dữ liệu đánh giá riêng.
III. Những điểm mình tập trung xây dựng
Đưa Model tự Fine-tune vào ứng dụng. MyNotebook sử dụng VietRAG-Embed, nối phần huấn luyện Embedding với một bài toán hỏi đáp thực tế.
Tách vai trò lưu trữ. Qdrant phụ trách tìm kiếm vector; Supabase lưu metadata, chunks và lịch sử hội thoại. Truy vấn được lọc theo user_id và chat_id để giới hạn phạm vi tài liệu. Đây là bộ lọc Retrieval, không thay thế xác thực và phân quyền API.
Xử lý trải nghiệm sau Retrieval. Giao diện HTML/CSS/JavaScript nhận SSE và render Markdown khi câu trả lời xuất hiện. Sau mỗi lượt, hệ thống giữ cả hội thoại đầy đủ và summary để hỗ trợ câu hỏi tiếp nối.
Mở rộng bằng Agent. Ngoài chế độ Retrieval, mã nguồn có chế độ Pro Agent xây dựng với LangChain: tìm trong tài liệu, tìm trên Web, tính toán và OCR ảnh. Agent được giới hạn 10 lần gọi công cụ mỗi lượt. OCR là công cụ riêng, chưa phải Pipeline tự động xử lý mọi PDF scan.
IV. Kết quả minh họa
Mình dùng một PDF mẫu mô tả kiến trúc MyNotebook để kiểm tra luồng tải tài liệu và hỏi đáp. Nội dung demo giúp đối chiếu câu trả lời với dữ liệu đầu vào, thay vì chỉ nhìn một đoạn văn do Model tạo ra.
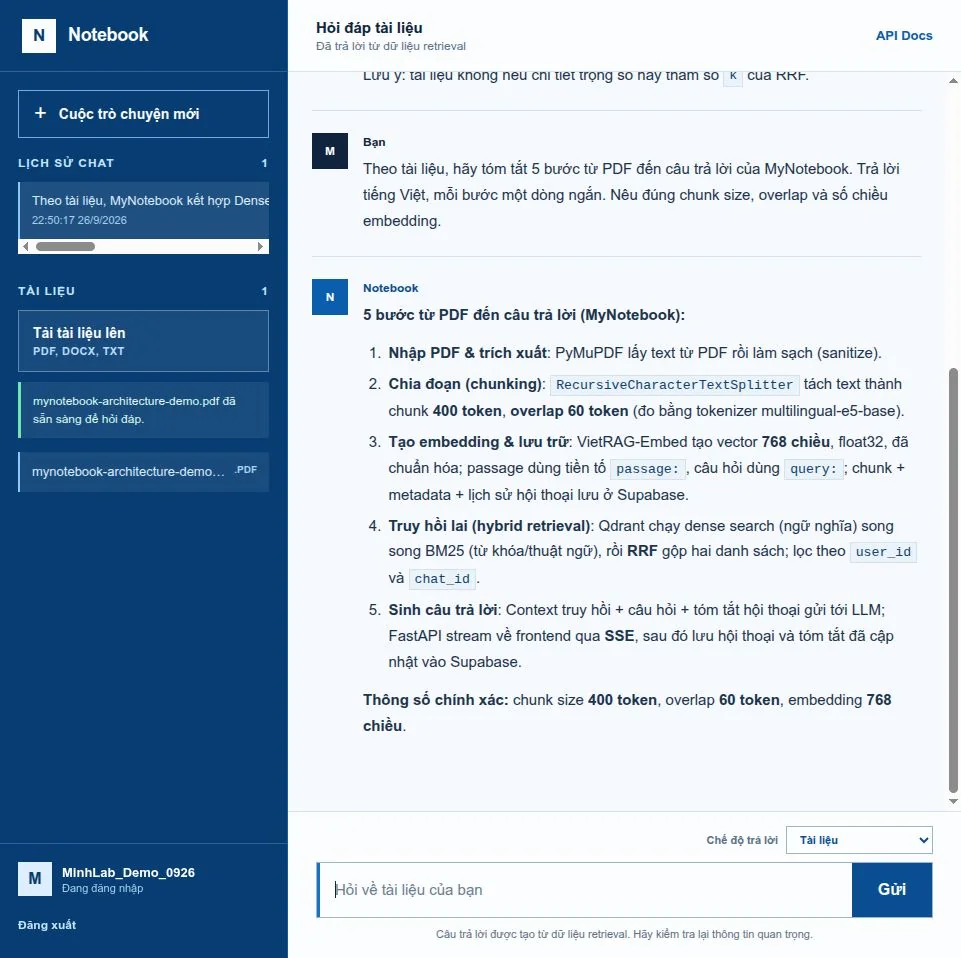
Ảnh đầu bài ghi lại câu trả lời cho yêu cầu tóm tắt 5 bước từ PDF đến kết quả. Trong lượt thử này, hệ thống trả về đúng các thông số 400 tokens, overlap 60 tokens và vector 768 chiều, đồng thời mô tả các thành phần PyMuPDF, Qdrant, Supabase và SSE. Đây là một kiểm tra minh họa trên tài liệu mẫu, chưa phải Benchmark chất lượng tổng quát.
V. Kiểm thử và giới hạn hiện tại
Trong lần kiểm tra phục vụ bài viết, 33 tests đạt ở nhóm API tài liệu, SSE, chuẩn hóa văn bản, AuthService, Web Search và bộ tính metric benchmark. Đây là kiểm tra thành phần, chưa chứng minh độ chính xác của toàn bộ hệ thống RAG.
Project vẫn còn các phần cần hoàn thiện: đồng bộ output của extractor TXT/DOCX với Pipeline, bổ sung Citation theo đoạn/trang và xác thực danh tính ở API trước khi triển khai thực tế. Query Router và luồng FAISS text-input hiện là phần thử nghiệm; Router chưa nối vào API chính, còn test text-input đang lỗi vì thiếu chat_id.
Bước tiếp theo của mình là đánh giá trên tập câu hỏi lớn hơn, gồm paraphrase, câu hỏi nhiều bước và câu hỏi ngoài tài liệu, thay vì suy rộng từ một demo nhỏ.
Với mình, giá trị của MyNotebook nằm ở việc nối được các phần của một ứng dụng AI: xử lý tài liệu, Embedding, Vector Database, LLM, Backend, streaming và kiểm thử. Repo thể hiện cách mình tổ chức và kiểm tra các thành phần đó trong cùng một project.
Source Code: MyNotebook trên GitHub.
Thảo luận bài viết
Câu hỏi, ghi chú và góc nhìn của bạn về nội dung này.